はじめに
こんにちは、STS技術チームです。
今回はSnowflakeの「セマンティックビュー」という機能をご紹介します。
セマンティックビューとは、テーブルに「売上総額」や「顧客名」といったビジネスの言葉でわかりやすい意味を付けられる仕組みのことです。
誰が見ても同じ意味でデータを扱えるようになるので、AIによる分析の精度アップやチーム間の集計ズレ防止に役立ちます。
本記事では、セマンティックビューの基本的な考え方から作成手順、そして通常のSQLとの違いを、Cortex Agents(自然言語でデータ分析を行うAIエージェント機能)での検証を通してご紹介します。
具体的には、(1)概念と構成要素の解説、(2)SQL DDL(オブジェクトを定義するSQL)を使った実際の作成手順、(3)通常のSQLとの比較およびCortex Agentsでのメタデータ充実度による精度検証、という3つのステップで進めます。
本記事でわかること
- セマンティックビューとは何か、なぜ必要なのか
- Fact・Dimension・Metricという3つの構成要素の役割と違い
- セマンティックビューを作成する3つの方法(SQL DDL・YAML・Snowsight UI)の特徴
- SQL DDL(CREATE SEMANTIC VIEW文)を使った、実際のセマンティックビューの作成手順
- 通常のSQLとSEMANTIC_VIEW句で同じ分析をしたときの記述量・可読性の違い
- Cortex Agentsでの自然言語分析において、セマンティックビューのメタデータの充実度が回答精度にどう影響するか
概要
本記事の目的は、次の3点です。
(1)セマンティックビューの基本を理解する
(2)SQL DDLで作成できるようになる
(3)メタデータの充実度がCortex Agentsの回答にどう影響するかを確認する
本記事の構成
本記事は、全3章で構成されています。
第1章でセマンティックビューの基本概念を解説し、第2章でSQL DDLによる作成手順を実践し、第3章で通常のSQLとの比較およびCortex Agentsでの精度検証を行います。
それでは、早速見ていきましょう。
第1章 セマンティックビューの概要説明
1. セマンティックビューとは
Snowflakeのセマンティックビュー(Semantic View)は、物理テーブルにビジネス上の意味を付与する抽象化レイヤーです。スキーマレベルのオブジェクトとして、データベースの中に格納されます。
データベースのテーブルやカラムの名前は、技術的な略称(例:amt_ttl_pre_dsc)で保存されていることが多く、ビジネスユーザーにとっては直感的に理解しにくいものです。セマンティックビューは、こうした物理データに対して「売上総額」「顧客名」「注文日」といったビジネス上の意味を定義し、データの発見や解釈をしやすくしてくれます。
さらに、「純売上」のような指標を組織内で SUM(gross_revenue * (1 - discount)) として一意に定義できるので、レポートやアプリケーションごとに計算ロジックがばらついてしまう問題を解消し、Single Source of Truth(信頼できる唯一の情報源)を実現できます。
セマンティックビューは、以下のような用途で活用されています。
- AIアプリケーション(Cortex Agentsなど):Cortex Agentsなどのエージェントが、セマンティックビューの定義を読み取り、物理テーブルに対するSQLを自動生成できます
- BIツール:ツールを横断して一貫したメトリクス・ディメンションを提供し、ビジネスユーザーのセルフサービス分析を支援します
- テクニカルアナリスト:メトリクス定義の重複を排除し、複雑なスキーマ間のリレーションシップを一元管理できます
2. 3つの構成要素:Fact・Dimension・Metric
セマンティックビューでは、物理テーブルを「論理テーブル(Logical Table)」として登録し、その上にFact・Dimension・Metricという3つの概念を定義します。
Fact(ファクト)
Factは、論理テーブルの行レベルの属性を表します。
個々のビジネスイベントやトランザクションの数値を捉えるもので、「いくら(how much)」「いくつ(how many)」といった情報を最も細かい粒度で保持します。
Factは、DimensionやMetricを組み立てるための中間的な計算要素(ヘルパー)として使われることが多いのが特徴です。クエリ結果として直接返すこともできますが、主な役割はMetricの材料を準備することにあります。
コード例です。
FACTS (
  line_items.discounted_line_amount AS l_extendedprice * (1 - l_discount)
    COMMENT = '割引後明細金額',
  orders.count_line_items AS COUNT(line_items.line_item_id)
)
Dimension(ディメンション)
Dimensionは、データのカテゴリ属性を表します。
「誰が(who)」「何を(what)」「どこで(where)」「いつ(when)」という問いに答え、メトリクスをグループ化・フィルタリングするための切り口を提供します。
Dimensionには、カラムをそのまま参照する「直接ディメンション」と、YEAR(o_orderdate) のようにSQL式で変換する「計算ディメンション」があります。また、synonyms(同義語)やsample_values(サンプル値)を設定すれば、Cortex Analyst(自然言語からSQLを生成する機能)による自然言語クエリの精度を上げることができます。
コード例です。
DIMENSIONS (
  customers.customer_name AS c_name
    COMMENT = '顧客名',
  orders.order_date AS o_orderdate
    COMMENT = '注文日',
  orders.order_year AS YEAR(o_orderdate)
    COMMENT = '注文年'
)
Metric(メトリクス)
Metricは、Factやカラムを集約関数(SUM、AVG、COUNTなど)で集計した、ビジネス上のKPI(主要業績評価指標)です。
複数行のデータを集約し、レポートやダッシュボードで使う「測定値」を定義します。
Metricには、特定の論理テーブルに属する「テーブルスコープメトリクス」と、複数テーブルのメトリクスを組み合わせた「派生メトリクス(Derived Metric)」があります。派生メトリクスは、テーブル名を省略して定義します。
コード例です。
METRICS (
  orders.order_average_value AS AVG(o_totalprice)
    COMMENT = '平均注文額',
  orders.average_line_items_per_order AS AVG(orders.count_line_items)
    COMMENT = '注文あたりの平均明細数',
  -- 派生メトリクス(テーブル名なし)
  combined_metric AS table_1.metric_1 + table_2.metric_2
)
3つの概念の関係
- Fact:行レベルの粒度です。個々のトランザクションの数値を保持し、Metricの材料になります(例:割引後明細金額、明細ID)
- Dimension:行レベルの粒度です。データのグルーピング・フィルタリングの切り口を提供します(例:顧客名、注文日、地域)
- Metric:集計レベルの粒度です。Factを集約したビジネスKPIです(例:平均注文額、顧客数)
3. 作成インターフェースの選択肢
セマンティックビューは、以下の3つの方法で作成できます。
どの方法で作成しても、Snowflake内部では同一のセマンティックビューオブジェクトが生成されます。
SQL DDL
SQLに慣れているチームに向いている方法です。CREATE SEMANTIC VIEW 文を使って、テーブル・リレーションシップ・Fact・Dimension・Metricを宣言的に定義します。
向いているケースは以下のとおりです。
- チームがSQLワークフロー中心で作業している場合
- dbtやTerraformを通じてデプロイしている場合
- JDBC / ODBC / SQL API経由でプログラマティックに作成したい場合
コード例です。
CREATE SEMANTIC VIEW tpch_rev_analysis
  TABLES (
    orders AS SNOWFLAKE_SAMPLE_DATA.TPCH_SF1.ORDERS
      PRIMARY KEY (o_orderkey),
    customers AS SNOWFLAKE_SAMPLE_DATA.TPCH_SF1.CUSTOMER
      PRIMARY KEY (c_custkey)
  )
  RELATIONSHIPS (
    orders_to_customers AS orders (o_custkey) REFERENCES customers
  )
  DIMENSIONS (
    customers.customer_name AS c_name
  )
  METRICS (
    orders.order_average_value AS AVG(o_totalprice)
  );
YAML
簡潔で可読性の高い形式で、多数のテーブルやカラムを持つ複雑なセマンティックビューに向いています。SYSTEM$CREATE_SEMANTIC_VIEW_FROM_YAML ストアドプロシージャで作成します。
向いているケースは以下のとおりです。
- PRレビューやdiffで変更を確認しやすい形式が望ましい場合
- CI/CDパイプラインがYAML構成ファイル中心である場合
- 既存のステージベースセマンティックモデル(YAML形式)から移行する場合
コード例です。
name: TPCH_REV_ANALYSIS
tables:
  - name: ORDERS
    base_table:
      database: SNOWFLAKE_SAMPLE_DATA
      schema: TPCH_SF1
      table: ORDERS
    primary_key:
      columns:
        - O_ORDERKEY
    dimensions:
      - name: ORDER_DATE
        expr: o_orderdate
        data_type: DATE
    metrics:
      - name: ORDER_AVERAGE_VALUE
        expr: AVG(o_totalprice)
Snowsight UI(Semantic View Autopilot)
Snowsightの「Workspaces」から「Add new」→「Semantic View」を選ぶと、AIアシスタントが対話形式でセマンティックビューの作成をガイドしてくれる「Semantic View Autopilot」を使えます。
Autopilotが提示する選択肢の中では、対話形式でセマンティックビューを作成できるAIアシスタント「Cortex Code」(略称CoCo)との対話による作成がSnowflakeから推奨されています。
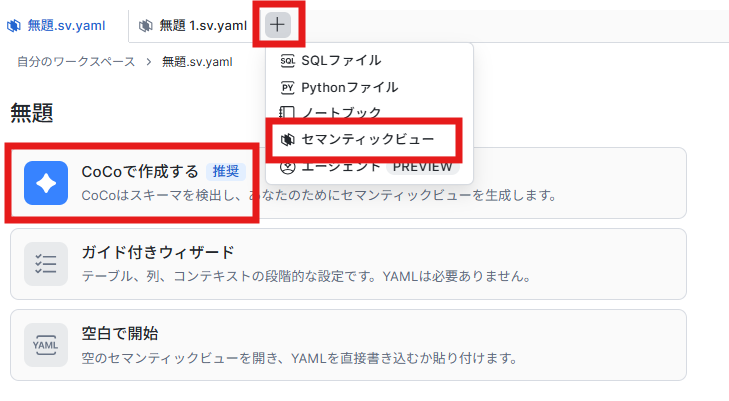
また、以下のファイルをインポートして、作成の起点にすることもできます。
- Tableauワークブック / データソース
- Power BIセマンティックモデル
- YAMLファイル / サンプルSQLクエリ
向いているケースは以下のとおりです。
- コードを書かずに素早くプロトタイプを作成したい場合
- 既存のBI資産(Tableau / Power BI)を活用して移行したい場合
フォーマット間の変換
DDL・YAML・Snowsightのいずれで作成しても、それぞれの形式に相互変換できます。
ただし一部の機能はそれぞれにしかありません。
- YAML → セマンティックビュー:
SYSTEM$CREATE_SEMANTIC_VIEW_FROM_YAML - セマンティックビュー → YAML:
SYSTEM$READ_YAML_FROM_SEMANTIC_VIEW - セマンティックビュー → DDL:
GET_DDL('SEMANTIC_VIEW', 'ビュー名')
これによって、バージョン管理・CI/CDパイプライン・環境間の定義移行をスムーズに行えます。
第2章 セマンティックビューの作成
本章では、SQL DDLを使ってセマンティックビューを作成する手順を解説します。
セマンティックビューの作成方法にはSQL DDL・YAML・Snowsight UIの3つがありますが、今回はSQL DDLによる作成方法を取り上げます。
使用するデータは、Snowflakeの新しいアカウントに標準で用意されているTPC-Hサンプルデータ(業界標準のベンチマークデータ。SNOWFLAKE_SAMPLE_DATA.TPCH_SF1)です。見当たらない場合は、管理者に作成を依頼してください。
2-1. テストデータの確認
セマンティックビューを作成する前に、対象となるテーブルのデータ内容を確認しましょう。
今回はTPC-HデータセットのORDERS(注文)、CUSTOMER(顧客)、LINEITEM(明細)の3テーブルを使用します。
データの確認SQL
-- 注文テーブルの確認
SELECT * FROM SNOWFLAKE_SAMPLE_DATA.TPCH_SF1.ORDERS LIMIT 10;
-- 顧客テーブルの確認
SELECT * FROM SNOWFLAKE_SAMPLE_DATA.TPCH_SF1.CUSTOMER LIMIT 10;-- 注文明細テーブルの確認
SELECT * FROM SNOWFLAKE_SAMPLE_DATA.TPCH_SF1.LINEITEM LIMIT 10;各テーブルの主なカラム
ORDERS(注文テーブル)
| カラム名 | 説明 |
|---|---|
| O_ORDERKEY | 注文キー(主キー) |
| O_CUSTKEY | 顧客キー(CUSTOMERテーブルへの外部キー) |
| O_TOTALPRICE | 注文合計金額 |
| O_ORDERDATE | 注文日 |
| O_ORDERSTATUS | 注文ステータス(F=完了、O=未処理、P=一部完了) |
| O_ORDERPRIORITY | 注文優先度(1-URGENT、2-HIGH、3-MEDIUM、4-NOT SPECIFIED、5-LOW) |
CUSTOMER(顧客テーブル)
| カラム名 | 説明 |
|---|---|
| C_CUSTKEY | 顧客キー(主キー) |
| C_NAME | 顧客名 |
| C_MKTSEGMENT | マーケットセグメント(AUTOMOBILE、BUILDING、FURNITURE、HOUSEHOLD、MACHINERY) |
LINEITEM(注文明細テーブル)
| カラム名 | 説明 |
|---|---|
| L_ORDERKEY | 注文キー(ORDERSテーブルへの外部キー) |
| L_LINENUMBER | 明細番号 |
| L_EXTENDEDPRICE | 割引前の明細金額 |
| L_DISCOUNT | 割引率 |
| L_RETURNFLAG | 返品フラグ(R=返品済み、A=受領済み、N=返品なし(未受領)) |
| L_LINESTATUS | 明細ステータス(F=出荷済み、O=未出荷) |
| L_SHIPMODE | 配送方法(AIR、MAIL、RAIL、REG AIR、SHIP、TRUCK、FOB) |
テーブル間のリレーションシップ
CUSTOMER (1) ←── (多) ORDERS (1) ←── (多) LINEITEM
c_custkey o_custkey / o_orderkey l_orderkey- 1人の顧客(CUSTOMER)は複数の注文(ORDERS)を持ちます
- 1件の注文(ORDERS)は複数の明細行(LINEITEM)を持ちます
必要な権限
セマンティックビューを作成するには、対象テーブルに対するSELECT権限、作成先スキーマに対するCREATE SEMANTIC VIEW権限、そして作成先データベースとスキーマに対するUSAGE権限が必要です。SNOWFLAKE_SAMPLE_DATAが作成済みで、参照権限が付与されていれば、テーブル側の追加権限設定は不要です。
2-2. CREATE SEMANTIC VIEWでセマンティックビューを作成
セマンティックビューの作成先となるデータベースとスキーマを用意し、CREATE SEMANTIC VIEWコマンドで作成します。今回はSQL DDL(CREATE SEMANTIC VIEW文)を使って作成します。
事前準備
-- セマンティックビューを格納するデータベース・スキーマ、ウェアハウスを作成(既存のものを使う場合は不要)
CREATE DATABASE IF NOT EXISTS MY_DB;
CREATE SCHEMA IF NOT EXISTS MY_DB.BLOG_SEMANTIC;
CREATE WAREHOUSE IF NOT EXISTS MY_WH
  WITH WAREHOUSE_SIZE = 'X-SMALL'
  AUTO_SUSPEND = 60
  AUTO_RESUME = TRUE
  INITIALLY_SUSPENDED = TRUE;
USE DATABASE MY_DB;
USE SCHEMA BLOG_SEMANTIC;
USE WAREHOUSE MY_WH;
CREATE SEMANTIC VIEWの構成要素
CREATE SEMANTIC VIEWコマンドでは、以下の要素を定義します。
| 項目名 | 内容 | 例 |
|---|---|---|
| TABLES(必須) | 分析対象の物理テーブルと主キーを指定する | ORDERS、CUSTOMER |
| RELATIONSHIPS | テーブル間の結合関係を定義する | 注文テーブルの顧客キーで顧客テーブルと紐づける |
| FACTS | メトリクス計算の材料となる行レベルの数値や式 | 割引後明細金額、明細ID |
| DIMENSIONS | データを切り分ける軸(グループ化・フィルタ項目) | 注文日、マーケットセグメント、配送方法 |
| METRICS | ビジネス上の集計指標 | 売上合計、平均注文金額、注文件数 |
| COMMENT | セマンティックビュー全体や各要素の説明文 | ‘顧客からの注文情報を管理するテーブル’ |
| AI_SQL_GENERATION | Cortex AnalystへのSQL生成ルール | ‘数値カラムは小数点以下2桁に丸めること’ |
| AI_QUESTION_CATEGORIZATION | Cortex Analystが対応する質問範囲の指示 | ‘売上・注文・顧客に関する質問に回答すること’ |
-- 既存オブジェクトを上書きする点に注意
create or replace semantic view MY_DB.BLOG_SEMANTIC.TPCH_REVENUE_ANALYSIS

  -- =====================================================
  -- tables: 論理テーブルの定義
  -- =====================================================
  tables (
    ORDERS as SNOWFLAKE_SAMPLE_DATA.TPCH_SF1.ORDERS
      primary key (O_ORDERKEY)
      with synonyms=('注文','受注','sales orders')
      comment='顧客からの注文情報。1行が1件の注文を表す',
    CUSTOMERS as SNOWFLAKE_SAMPLE_DATA.TPCH_SF1.CUSTOMER
      primary key (C_CUSTKEY)
      with synonyms=('顧客','取引先','customers')
      comment='顧客のマスタ情報。顧客名、所在国、マーケットセグメントなどを保持する',
    LINE_ITEMS as SNOWFLAKE_SAMPLE_DATA.TPCH_SF1.LINEITEM
      primary key (L_ORDERKEY,L_LINENUMBER)
      with synonyms=('注文明細','明細行','line items')
      comment='注文に含まれる商品の明細。1件の注文に対して複数の明細行が存在する'
  )

  -- =====================================================
  -- relationships: テーブル間の関係
  -- =====================================================
  relationships (
    ORDERS_TO_CUSTOMERS as ORDERS(O_CUSTKEY) references CUSTOMERS(C_CUSTKEY),
    LINE_ITEMS_TO_ORDERS as LINE_ITEMS(L_ORDERKEY) references ORDERS(O_ORDERKEY)
  )

  -- =====================================================
  -- facts: メトリクス計算の材料(行レベルの数値)
  -- =====================================================
  facts (
    ORDERS.line_item_count as COUNT(line_items.line_item_id)
      with synonyms=('明細行数')
      comment='注文あたりの明細行の数',
    LINE_ITEMS.line_item_id as CONCAT(l_orderkey, '-', l_linenumber)
      with synonyms=('明細ID')
      comment='注文キーと明細番号を結合した明細の一意識別子',
    LINE_ITEMS.discounted_line_amount as l_extendedprice * (1 - l_discount)
      with synonyms=('割引後明細金額')
      comment='割引前の明細金額(l_extendedprice)に割引率を適用した後の金額'
  )

  -- =====================================================
  -- dimensions: 分析の切り口(グルーピング・フィルタ軸)
  -- =====================================================
  dimensions (
    ORDERS.order_date as o_orderdate
      with synonyms=('注文日','受注日','order date')
      comment='注文が確定した日付',
    ORDERS.order_year as YEAR(o_orderdate)
      with synonyms=('注文年','受注年','order year')
      comment='注文が確定した年',
    ORDERS.order_month as MONTH(o_orderdate)
      with synonyms=('注文月','受注月','order month')
      comment='注文が確定した月(1-12)',
    ORDERS.order_status as o_orderstatus
      with synonyms=('注文ステータス','受注状態','order status')
      comment='注文の処理状態。F=完了, O=未処理, P=一部完了'
      sample_values ('F', 'O', 'P') is_enum,
    ORDERS.order_priority as o_orderpriority
      with synonyms=('注文優先度','優先順位','order priority')
      comment='注文の優先度。1-URGENT=緊急, 2-HIGH=高, 3-MEDIUM=中, 4-NOT SPECIFIED=指定なし, 5-LOW=低'
      sample_values ('1-URGENT', '2-HIGH', '3-MEDIUM', '4-NOT SPECIFIED', '5-LOW') is_enum,
    CUSTOMERS.customer_name as c_name
      with synonyms=('顧客名','customer name','取引先名')
      comment='顧客の正式名称',
    CUSTOMERS.market_segment as c_mktsegment
      with synonyms=('マーケットセグメント','市場区分','market segment')
      comment='顧客が属する市場区分。AUTOMOBILE=自動車, BUILDING=建設, FURNITURE=家具, HOUSEHOLD=家庭用品, MACHINERY=機械'
      sample_values ('AUTOMOBILE', 'BUILDING', 'FURNITURE', 'HOUSEHOLD', 'MACHINERY') is_enum,
    LINE_ITEMS.return_flag as l_returnflag
      with synonyms=('返品フラグ','返品区分','return flag')
      comment='返品状態を示すフラグ。R=返品済み, A=受領済み, N=返品なし(未受領)'
      sample_values ('R', 'A', 'N') is_enum,
    LINE_ITEMS.line_status as l_linestatus
      with synonyms=('明細ステータス','明細状態','line status')
      comment='明細行の処理状態。F=出荷済み, O=未出荷'
      sample_values ('F', 'O') is_enum,
    LINE_ITEMS.ship_mode as l_shipmode
      with synonyms=('配送方法','出荷方法','ship mode')
      comment='商品の配送手段。AIR=航空便, MAIL=郵便, RAIL=鉄道, REG AIR=通常航空便, SHIP=船便, TRUCK=トラック, FOB=本船渡し'
      sample_values ('AIR', 'MAIL', 'RAIL', 'REG AIR', 'SHIP', 'TRUCK', 'FOB') is_enum
  )

  -- =====================================================
  -- metrics: ビジネス指標(集約値)
  -- =====================================================
  metrics (
    CUSTOMERS.customer_count as COUNT(c_custkey)
      with synonyms=('顧客数','取引先数','customer count')
      comment='対象期間内の顧客数',
    ORDERS.order_count as COUNT(o_orderkey)
      with synonyms=('注文件数','受注件数','order count')
      comment='注文の総件数',
    ORDERS.avg_order_value as AVG(o_totalprice)
      with synonyms=('平均注文金額','平均受注額','average order value')
      comment='1注文あたりの平均金額(税込)',
    ORDERS.total_order_value as SUM(o_totalprice)
      with synonyms=('合計注文金額','総売上','total order value')
      comment='注文金額の合計',
    ORDERS.avg_line_items_per_order as AVG(orders.line_item_count)
      with synonyms=('平均明細行数','平均ライン数','average line items per order')
      comment='1注文あたりの平均明細行数',
    LINE_ITEMS.total_discounted_revenue as SUM(line_items.discounted_line_amount)
      with synonyms=('割引後売上合計','割引適用後売上','total discounted revenue')
      comment='割引適用後の売上合計金額'
  )
  comment='TPC-Hサンプルデータに基づく売上分析用セマンティックビュー。顧客・注文・明細の3テーブルを統合し、売上分析に必要な指標とディメンションを定義している'
  ai_sql_generation '数値カラムは小数点以下2桁に丸めること。日付でグルーピングする場合は新しい順(降順)に並べること。'
  ai_question_categorization '売上・注文・顧客に関する質問に回答すること。在庫や人事など、このデータに含まれない領域の質問は対象外であることを伝えること。';
作成SQLのポイント解説
【TABLES句】
- 物理テーブルに論理的な別名(orders、customers、line_items)を付与します
- PRIMARY KEYでテーブルの主キーを明示します(テーブル間の結合タイプの推定に使われます)
- WITH SYNONYMSで日本語・英語の別名を設定します(Cortex Analystが自然言語を認識する手がかりになります)
- COMMENTでテーブルの意味を説明します
【RELATIONSHIPS句】
- テーブル間の外部キー関係を定義します
orders (o_custkey) REFERENCES customersは、「注文テーブルのo_custkeyが顧客テーブルの主キーを参照する」ことを意味します
【FACTS句】
- Metricの計算材料となる行レベルの値を定義します
- CONCAT関数やCOUNT集約、算術式を使った計算ファクトも定義できます
【DIMENSIONS句】
- 分析の切り口となる項目を定義します
YEAR(o_orderdate)やMONTH(o_orderdate)のようなSQL式による計算ディメンションも定義できます- SAMPLE_VALUESで代表的な値を列挙し、IS_ENUMで全量であることを示すと、Cortex Analystのフィルタ精度が上がります
【METRICS句】
- COUNT、AVG、SUMなどの集約関数でビジネスKPIを定義します
- ファクトを参照するメトリクス(
AVG(orders.line_item_count)など)も定義できます
【AI_SQL_GENERATION】
- SQLを生成する際の指示を記述します
- 数値の丸め方やソート順など、生成SQLの書式を統制できます
【AI_QUESTION_CATEGORIZATION】
- Cortex Analystが質問を分類する際の指示を記述します
- 対象外の質問に対して、適切な応答を返せるようになります
2-3. 作成したセマンティックビューの確認
セマンティックビューが正しく作成されたことを、以下のコマンドで確認しましょう。
セマンティックビューの一覧確認
-- 現在のスキーマ内のセマンティックビュー一覧を表示
SHOW SEMANTIC VIEWS;
作成したセマンティックビュー(TPCH_REVENUE_ANALYSIS)が一覧に表示されることを確認します。
セマンティックビューの詳細確認
-- テーブル、リレーションシップ、ディメンション、ファクト、メトリクスの定義内容を一覧表示
DESCRIBE SEMANTIC VIEW TPCH_REVENUE_ANALYSIS;
DESCRIBE SEMANTIC VIEWコマンドの出力には、各オブジェクトの種類(TABLE、RELATIONSHIP、DIMENSION、FACT、METRIC)、名前、親テーブル、プロパティ(EXPRESSION、DATA_TYPE、COMMENTなど)が含まれます。定義内容が意図どおりであるか確認しましょう。
ディメンション・ファクト・メトリクスの個別確認
-- ディメンションの確認
SHOW SEMANTIC DIMENSIONS IN MY_DB.BLOG_SEMANTIC.TPCH_REVENUE_ANALYSIS;
-- ファクトの確認
SHOW SEMANTIC FACTS IN MY_DB.BLOG_SEMANTIC.TPCH_REVENUE_ANALYSIS;-- メトリクスの確認
SHOW SEMANTIC METRICS IN MY_DB.BLOG_SEMANTIC.TPCH_REVENUE_ANALYSIS;各コマンドで、定義したディメンション・ファクト・メトリクスの名前、データ型、SYNONYMS、COMMENTが正しく設定されていることを確認します。
セマンティックビューを使ったクエリ実行
SEMANTIC_VIEW句を使うと、定義したディメンションとメトリクスでクエリを実行できます。
-- 例1: 注文年ごとの平均注文額と注文件数を取得
SELECT * FROM SEMANTIC_VIEW(
  MY_DB.BLOG_SEMANTIC.TPCH_REVENUE_ANALYSIS
  METRICS orders.avg_order_value, orders.order_count
  DIMENSIONS orders.order_year
)
ORDER BY order_year DESC;
-- 例2: マーケットセグメントごとの顧客数と合計注文金額を取得
SELECT * FROM SEMANTIC_VIEW(
MY_DB.BLOG_SEMANTIC.TPCH_REVENUE_ANALYSIS
METRICS customers.customer_count, orders.total_order_value
DIMENSIONS customers.market_segment
)
ORDER BY total_order_value DESC;-- 例3: 配送方法ごとの割引後売上合計を取得
SELECT * FROM SEMANTIC_VIEW(
MY_DB.BLOG_SEMANTIC.TPCH_REVENUE_ANALYSIS
METRICS line_items.total_discounted_revenue
DIMENSIONS line_items.ship_mode
)
ORDER BY total_discounted_revenue DESC;SEMANTIC_VIEW句を使うときのポイントは、以下のとおりです。
- METRICSで取得したいメトリクスを指定します(テーブル名.メトリクス名)
- DIMENSIONSで分析の切り口を指定します(テーブル名.ディメンション名)
- 結果は、DIMENSIONSで指定した値でグループ化されます
- 通常のSQLと同様に、ORDER BYやLIMITも使用できます
DDL定義の再取得
作成したセマンティックビューのSQL定義を再取得したい場合は、GET_DDL関数を使用します。
SELECT GET_DDL('SEMANTIC_VIEW', 'MY_DB.BLOG_SEMANTIC.TPCH_REVENUE_ANALYSIS', TRUE);YAML形式での取得
セマンティックビューの定義をYAML形式で確認することもできます。
一部機能を除き、DDLとYAMLは、ほぼ同等の機能を持ち、相互に変換できます。そのため、CI/CDパイプラインやバージョン管理での利用に便利です。
SELECT SYSTEM$READ_YAML_FROM_SEMANTIC_VIEW('MY_DB.BLOG_SEMANTIC.TPCH_REVENUE_ANALYSIS');第3章 通常のSQLとの比較と、メタデータの充実度による精度検証
本章では、第2章で作成したセマンティックビューTPCH_REVENUE_ANALYSISを活用し、同じ分析目的を異なるアプローチで実行したときの手順・記述量・可読性の違いを比較します。
比較1では、通常のSQL(物理テーブルへの直接クエリ)とSEMANTIC_VIEW句を使った場合の違いを、比較2では、Cortex Agents(自然言語)で分析した際のセマンティックビューのメタデータ充実度による精度の差を確認します。
なお、Cortex Agentsは2026年4月13日のリリースより、cortex_analyst_text_to_sqlツールを使う場合のSQL生成方式が、Cortex Analystサービスへの委任から、エージェント自身が直接SQLを生成する方式に変更されています。これに伴い、レスポンス内のブロック形式もcortex_analyst_text_to_sqlからsystem_execute_sqlに変わりましたが、エージェントの設定(tool_specやtool_resources)自体は変更不要です。本記事のSQLもそのままお使いいただけます。
3-1. 比較1:同じ分析を通常のSQLとSEMANTIC_VIEW句で実行
3つの分析テーマを用意し、それぞれ「通常のSQL」と「SEMANTIC_VIEW句」の両方で同じ結果を得るクエリを並べて比較します。
分析テーマ1:マーケットセグメント別の注文件数と平均注文金額
【通常のSQL】
SELECT
    c.c_mktsegment AS "マーケットセグメント",
    COUNT(o.o_orderkey) AS "注文件数",
    ROUND(AVG(o.o_totalprice), 2) AS "平均注文金額"
FROM SNOWFLAKE_SAMPLE_DATA.TPCH_SF1.ORDERS o
JOIN SNOWFLAKE_SAMPLE_DATA.TPCH_SF1.CUSTOMER c
    ON o.o_custkey = c.c_custkey
GROUP BY c.c_mktsegment
ORDER BY "注文件数" DESC;
【SEMANTIC_VIEW句】
SELECT
  market_segment  AS "マーケットセグメント",
  order_count     AS "注文件数",
  ROUND(avg_order_value, 2) AS "平均注文金額"
FROM SEMANTIC_VIEW(
  MY_DB.BLOG_SEMANTIC.TPCH_REVENUE_ANALYSIS
  METRICS orders.order_count, orders.avg_order_value
  DIMENSIONS customers.market_segment
)
ORDER BY "注文件数" DESC;
実行結果
| マーケットセグメント | 注文件数 | 平均注文金額 |
|---|---|---|
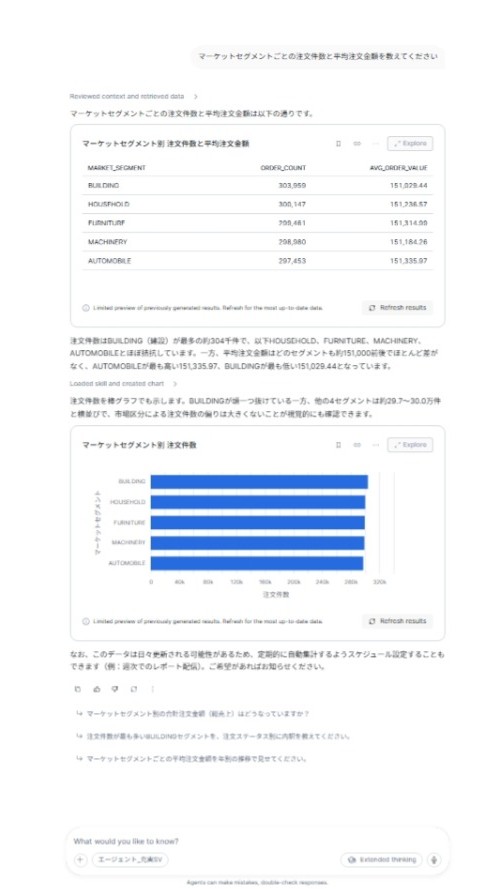
| BUILDING | 303,959 | 151,029.44 |
| HOUSEHOLD | 300,147 | 151,236.57 |
| FURNITURE | 299,461 | 151,314.99 |
| MACHINERY | 298,980 | 151,184.26 |
| AUTOMOBILE | 297,453 | 151,335.97 |
【比較ポイント】
- 通常のSQLでは、JOIN条件やテーブルの完全修飾名を記述する必要があります
- SEMANTIC_VIEW句では、リレーションシップが定義済みのため、JOINの記述が不要です
- メトリクスの計算ロジック(COUNTやAVG)もセマンティックビュー側に定義済みのため、分析者は「何を見たいか」だけを指定すればよくなります
分析テーマ2:注文年・注文ステータス別の合計注文金額
【通常のSQL】
SELECT
    YEAR(o.o_orderdate) AS "注文年",
    o.o_orderstatus AS "注文ステータス",
    ROUND(SUM(o.o_totalprice), 2) AS "合計注文金額"
FROM SNOWFLAKE_SAMPLE_DATA.TPCH_SF1.ORDERS o
GROUP BY YEAR(o.o_orderdate), o.o_orderstatus
ORDER BY "注文年" DESC, "合計注文金額" DESC;
【SEMANTIC_VIEW句】
SELECT
  order_year        AS "注文年",
  order_status      AS "注文ステータス",
  total_order_value AS "合計注文金額"
FROM SEMANTIC_VIEW(
  MY_DB.BLOG_SEMANTIC.TPCH_REVENUE_ANALYSIS
  METRICS orders.total_order_value
  DIMENSIONS orders.order_year, orders.order_status
)
ORDER BY "注文年" DESC, "合計注文金額" DESC;
実行結果(抜粋)
| 注文年 | 注文ステータス | 合計注文金額 |
|---|---|---|
| 1998 | O | 20,212,721,905.53 |
| 1997 | O | 34,373,633,413.04 |
| 1996 | O | 34,609,364,760.86 |
| 1995 | O | 20,822,054,361.33 |
| 1995 | P | 7,109,117,393.01 |
| 1995 | F | 6,614,961,429.26 |
| 1994 | F | 34,416,369,052.97 |
| 1993 | F | 34,340,410,079.03 |
| 1992 | F | 34,330,674,052.43 |
【比較ポイント】
YEAR(o_orderdate)のような計算ディメンションが「注文年」として定義済みのため、SQL関数の知識がなくても分析できます- 注文ステータスの値の意味(F=完了、O=未処理、P=一部完了)はセマンティックビューのCOMMENTに記載されているので、Cortex Agentsが活用できます
分析テーマ3:配送方法別の割引後売上合計
【通常のSQL】
SELECT
    l.l_shipmode AS "配送方法",
    ROUND(SUM(l.l_extendedprice * (1 - l.l_discount)), 2) AS "割引後売上合計"
FROM SNOWFLAKE_SAMPLE_DATA.TPCH_SF1.LINEITEM l
GROUP BY l.l_shipmode
ORDER BY "割引後売上合計" DESC;
【SEMANTIC_VIEW句】
SELECT
  ship_mode                AS "配送方法",
  ROUND(total_discounted_revenue, 2) AS "割引後売上合計"
FROM SEMANTIC_VIEW(
  MY_DB.BLOG_SEMANTIC.TPCH_REVENUE_ANALYSIS
  METRICS line_items.total_discounted_revenue
  DIMENSIONS line_items.ship_mode
)
ORDER BY "割引後売上合計" DESC;
実行結果
| 配送方法 | 割引後売上合計 |
|---|---|
| AIR | 31,223,576,376.32 |
| SHIP | 31,193,760,401.04 |
| REG AIR | 31,151,023,704.09 |
| FOB | 31,149,684,716.78 |
| RAIL | 31,141,547,823.05 |
| 31,134,972,575.31 | |
| TRUCK | 31,107,658,288.41 |
【比較ポイント】
- 通常のSQLでは、
l_extendedprice * (1 - l_discount)という計算式を分析者が知っている必要があります - セマンティックビューでは「割引後売上合計」というビジネス上の名前で参照するだけでよく、計算ロジックの知識は不要です
- 計算ロジックがセマンティックビュー内で一元管理されるため、組織全体で一貫した指標定義を使えます(Single Source of Truth)
比較1のまとめ
| 観点 | 通常のSQL | SEMANTIC_VIEW句 |
|---|---|---|
| JOIN記述 | 必要(テーブル間の結合条件を明示) | 不要(リレーションシップ定義済み) |
| テーブル名 | 完全修飾名が必要 | 論理名で参照可能 |
| 計算ロジック | 分析者がSQLで記述 | セマンティックビューに定義済み |
| カラム名 | 物理カラム名(技術的略称) | ビジネス名で定義した英語名 |
| SQL記述量 | 多い | 複数テーブルの分析で少なくなる |
| 必要スキル | SQLの結合・集約・関数の知識 | メトリクス名・ディメンション名の理解 |
| 指標の一貫性 | 分析者ごとに計算式が異なるリスクあり | 定義が一元管理され一貫性が保たれる |
3-2. 比較2:Cortex Agents(自然言語)での分析
比較2では、Cortex Agentsを使った自然言語での分析を行います。
同じ質問を、メタデータが充実したセマンティックビューと最小限のセマンティックビューの2つのエージェントに投げかけ、回答の可否・内容の違いを比較します。
必要な権限
第3章の手順には、次の権限と環境が必要です。
- スキーマに対する
CREATE AGENT権限 - (ステップ3を行う場合)Snowflake CoWork(エージェントに自然言語で質問できるSnowflakeの機能)のオブジェクト(SQL上は
SNOWFLAKE INTELLIGENCE)に対するMODIFY権限 - 対象エージェントに対する
USAGE権限 - セマンティックビューに対する
SELECT権限 - 作成先データベースとスキーマに対する
USAGE権限 - 利用できるウェアハウス
- アカウントのリージョンによっては、クロスリージョン推論(他リージョンで推論を処理する設定)の有効化(管理者による
CORTEX_ENABLED_CROSS_REGIONパラメータの設定)
ステップ1:2つのセマンティックビューを用意する
Cortex Analystツールにはセマンティックビューが必要なため、比較の切り口を「メタデータが充実したセマンティックビュー」対「最小限のセマンティックビュー」に変えます。
- セマンティックビューA(充実版):第2章で作成した
TPCH_REVENUE_ANALYSIS(COMMENT、SYNONYMS、SAMPLE_VALUES、AI_SQL_GENERATIONなどをすべて設定済み) - セマンティックビューB(最小限版):テーブル定義・リレーションシップ・最低限のディメンションと注文単位のメトリクスのみで、COMMENT・SYNONYMS・SAMPLE_VALUES・AI_SQL_GENERATIONなどの説明用メタデータや、割引後金額の計算ロジック(FACT/METRIC)を付与していないもの
-- 比較用:メタデータなしの最小セマンティックビュー
-- 既存オブジェクトを上書きする点に注意
CREATE OR REPLACE SEMANTIC VIEW MY_DB.BLOG_SEMANTIC.TPCH_MINIMAL

  TABLES (
    orders AS SNOWFLAKE_SAMPLE_DATA.TPCH_SF1.ORDERS
      PRIMARY KEY (o_orderkey),
    customers AS SNOWFLAKE_SAMPLE_DATA.TPCH_SF1.CUSTOMER
      PRIMARY KEY (c_custkey),
    line_items AS SNOWFLAKE_SAMPLE_DATA.TPCH_SF1.LINEITEM
      PRIMARY KEY (l_orderkey, l_linenumber)
  )

  RELATIONSHIPS (
    orders_to_customers AS
      orders (o_custkey) REFERENCES customers,
    line_items_to_orders AS
      line_items (l_orderkey) REFERENCES orders
  )

  -- ディメンション: 物理カラム名そのまま、COMMENT/SYNONYMS/SAMPLE_VALUES なし
  DIMENSIONS (
    customers.c_mktsegment AS c_mktsegment,
    orders.o_orderdate AS o_orderdate,
    orders.o_orderstatus AS o_orderstatus,
    orders.o_orderpriority AS o_orderpriority,
    line_items.l_shipmode AS l_shipmode,
    line_items.l_returnflag AS l_returnflag,
    line_items.l_linestatus AS l_linestatus
  )

  -- メトリクス: 最低限の集約のみ、COMMENT/SYNONYMS なし
  METRICS (
    orders.order_count AS COUNT(o_orderkey),
    orders.avg_order_value AS AVG(o_totalprice),
    orders.total_order_value AS SUM(o_totalprice)
  );
【2つのセマンティックビューの違い】
| 項目 | TPCH_REVENUE_ANALYSIS(充実版) | TPCH_MINIMAL(最小限版) |
|---|---|---|
| ディメンション名 | 英語ビジネス名 + 日本語SYNONYMS(例:MARKET_SEGMENT / マーケットセグメント) | 物理カラム名(例:c_mktsegment) |
| COMMENT | 全項目に詳細な説明あり | なし |
| SYNONYMS | 日本語・英語の別名あり | なし |
| SAMPLE_VALUES / IS_ENUM | 列挙値を明示 | なし |
| FACTS(計算項目) | 割引後明細金額などを定義 | なし |
| 計算ディメンション | 注文年、注文月など | なし |
| AI_SQL_GENERATION | 丸め・ソート順の指示あり | なし |
| AI_QUESTION_CATEGORIZATION | 対象外質問の制御あり | なし |
ステップ2:2つのCortex Agentsを作成する
以下のSQLで、充実版・最小限版それぞれのセマンティックビューを使用するCortex Agentsを作成します。
-- エージェントA: 充実したセマンティックビューを使用
-- オブジェクト名に日本語を使う場合はダブルクオートで囲む
-- 既存オブジェクトを上書きする点に注意
CREATE OR REPLACE AGENT MY_DB.BLOG_SEMANTIC."エージェント_充実SV"
  COMMENT = '充実したセマンティックビューを使用した売上分析エージェント'
  FROM SPECIFICATION
  $$
  models:
    orchestration: auto

  tools:
    - tool_spec:
        type: cortex_analyst_text_to_sql
        name: Analyst1
        description: "セマンティックビューを使用して売上・注文・顧客データを分析する"

  tool_resources:
    Analyst1:
      semantic_view: "MY_DB.BLOG_SEMANTIC.TPCH_REVENUE_ANALYSIS"
      execution_environment:
        type: warehouse
        warehouse: "MY_WH"
  $$;
-- エージェントB: 最小限のセマンティックビューを使用
-- オブジェクト名に日本語を使う場合はダブルクオートで囲む
-- 既存オブジェクトを上書きする点に注意
CREATE OR REPLACE AGENT MY_DB.BLOG_SEMANTIC."エージェント_最小SV"
COMMENT = '最小限のセマンティックビューを使用した売上分析エージェント'
FROM SPECIFICATION
$$
models:
orchestration: auto
tools:
- tool_spec:
type: cortex_analyst_text_to_sql
name: Analyst1
description: "最小限のセマンティックビューを使用して売上データを分析する"
tool_resources:
Analyst1:
semantic_view: "MY_DB.BLOG_SEMANTIC.TPCH_MINIMAL"
execution_environment:
type: warehouse
warehouse: "MY_WH"
$$;ステップ3:作成した2つのCortex AgentsをCoWorkオブジェクトに追加する
ステップ3は、アカウントにCoWorkオブジェクトがある場合のみ行います。次のコマンドで存在を確認してください。
SHOW SNOWFLAKE INTELLIGENCES;結果が空の場合、ステップ3は不要です。アクセス権のあるエージェントが自動で表示されます。
結果が返る場合は、以下のSQLでエージェントを追加します。追加しないとCoWorkに表示されません。追加は、CoWorkオブジェクトに対するMODIFY権限と、対象エージェントに対するUSAGE権限を持つ専用ロールで行ってください。
-- CoWorkオブジェクトにエージェント_充実SVを追加
ALTER SNOWFLAKE INTELLIGENCE SNOWFLAKE_INTELLIGENCE_OBJECT_DEFAULT
  ADD AGENT MY_DB.BLOG_SEMANTIC."エージェント_充実SV";
-- CoWorkオブジェクトにエージェント_最小SVを追加
ALTER SNOWFLAKE INTELLIGENCE SNOWFLAKE_INTELLIGENCE_OBJECT_DEFAULT
ADD AGENT MY_DB.BLOG_SEMANTIC."エージェント_最小SV";ステップ4:同じ質問を両エージェントに投げかける
Cortex Agentsへの質問は、Snowsight UIのエージェントプレイグラウンド、REST API、またはSQL関数(SNOWFLAKE.CORTEX.DATA_AGENT_RUN)で実行できます。
ここでは、Snowflake CoWork(SQL上はSNOWFLAKE INTELLIGENCEオブジェクトとして管理されます)での実行例をご紹介します。
用意した質問は、以下の5つです。それぞれの質問に対する、エージェントA(充実したセマンティックビュー)とエージェントB(最小限のセマンティックビュー)の回答画面は以下のとおりです。
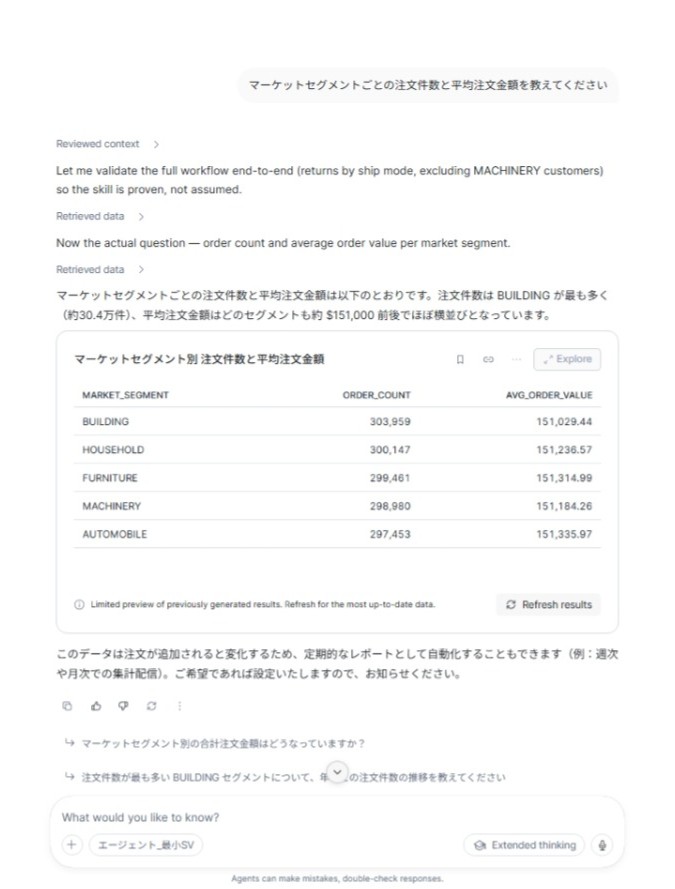
質問1:「マーケットセグメントごとの注文件数と平均注文金額を教えてください」
エージェントAの回答
エージェントBの回答
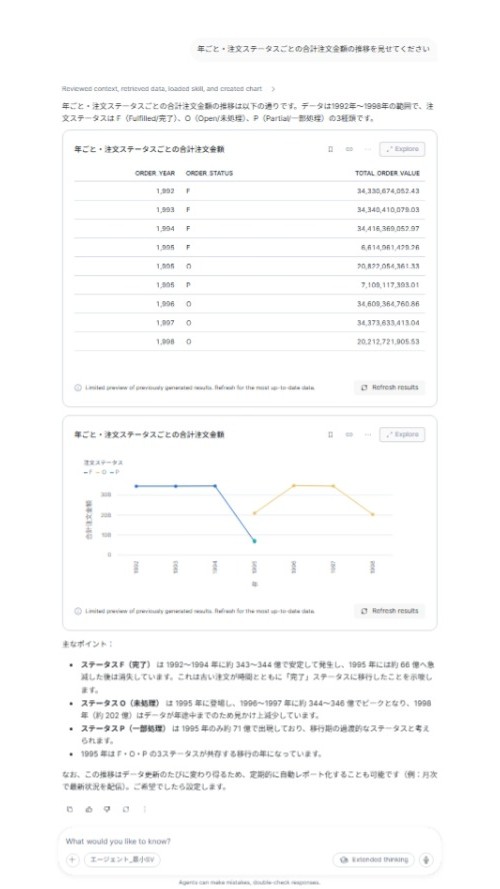
質問2:「年ごと・注文ステータスごとの合計注文金額の推移を見せてください」
エージェントAの回答
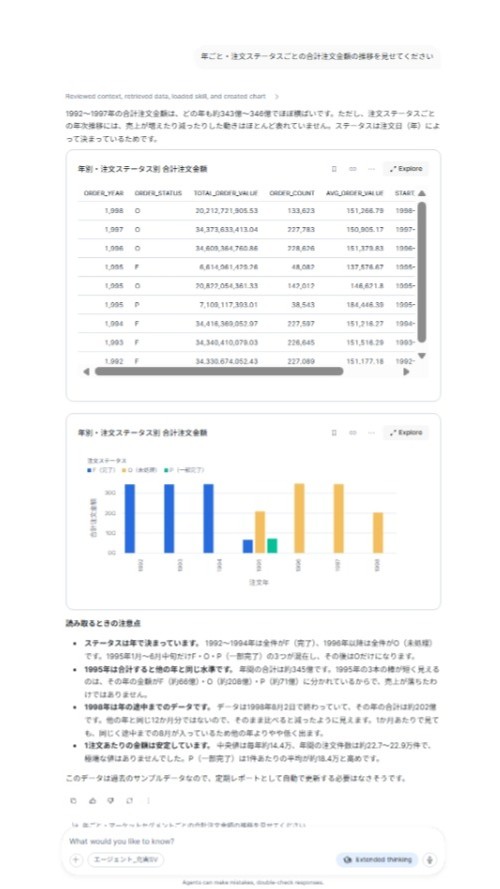
エージェントBの回答
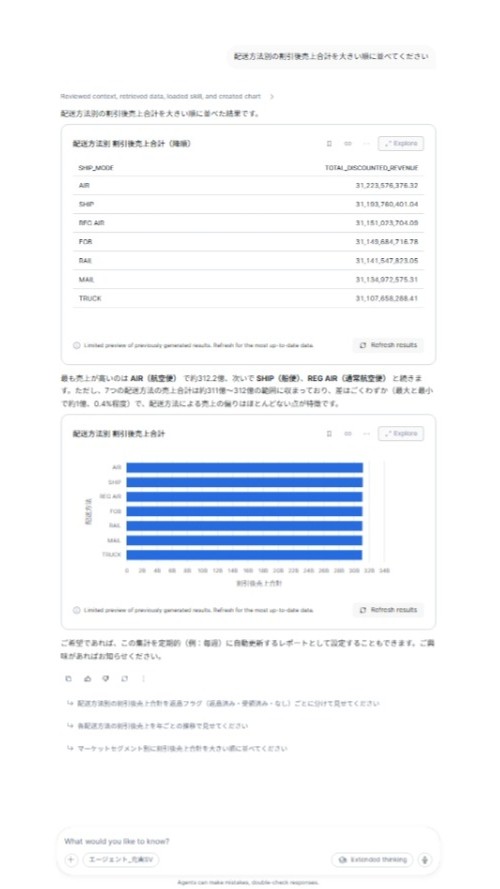
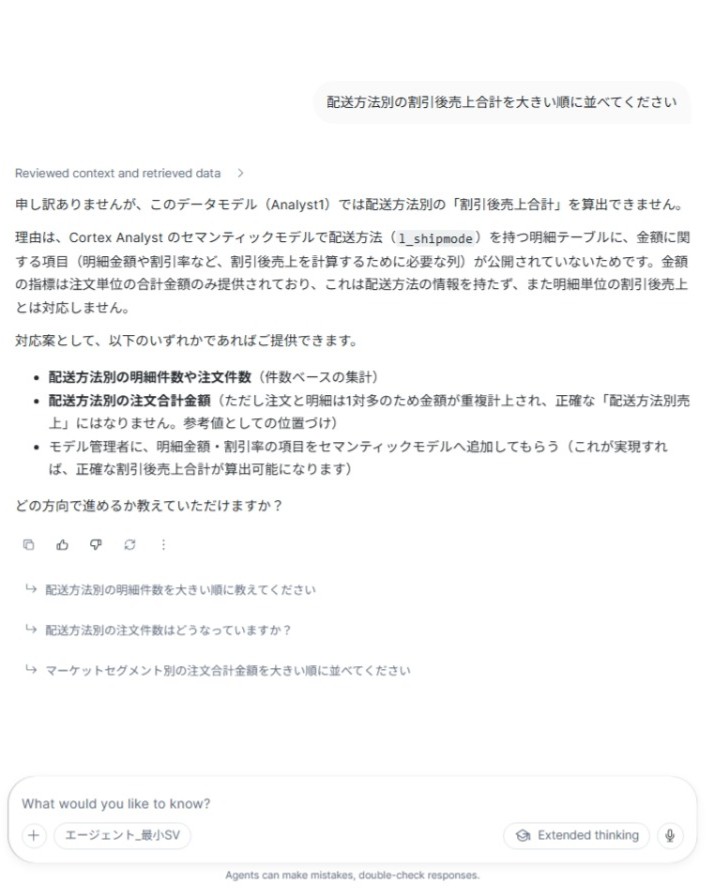
質問3:「配送方法別の割引後売上合計を大きい順に並べてください」
エージェントAの回答
エージェントBの回答
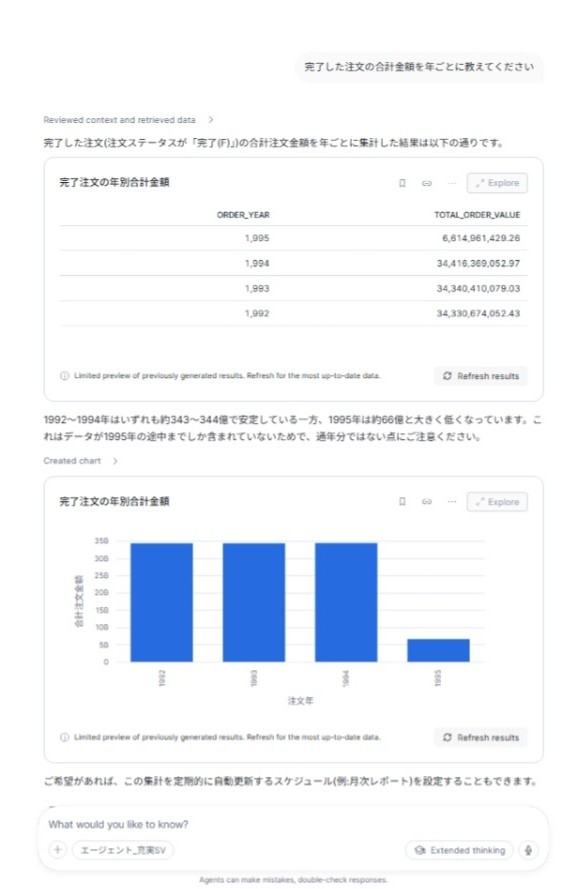
質問4:「完了した注文の合計金額を年ごとに教えてください」
エージェントAの回答
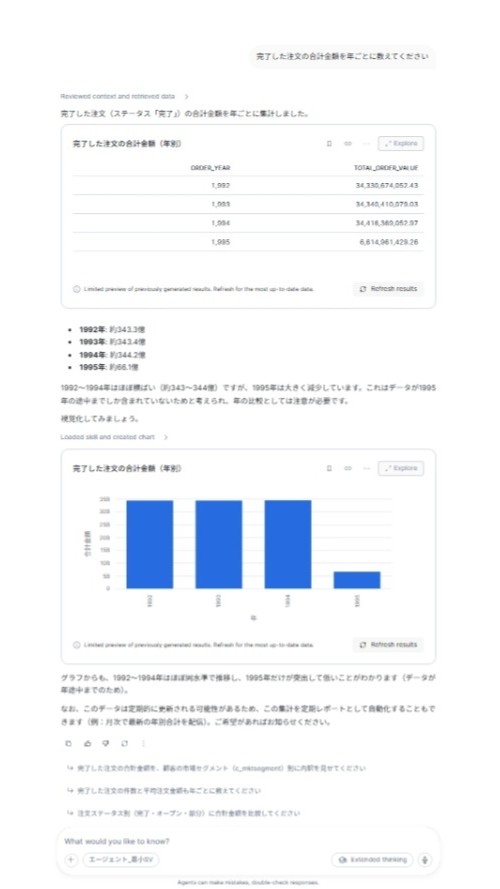
エージェントBの回答
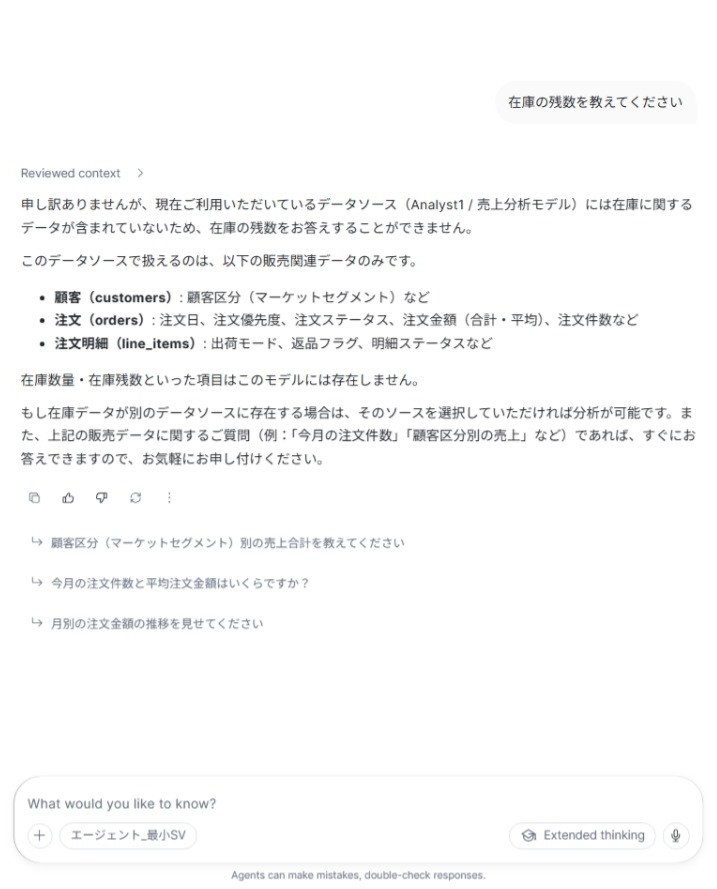
質問5:「在庫の残数を教えてください」(このセマンティックビューの対象外データについての質問)
エージェントAの回答
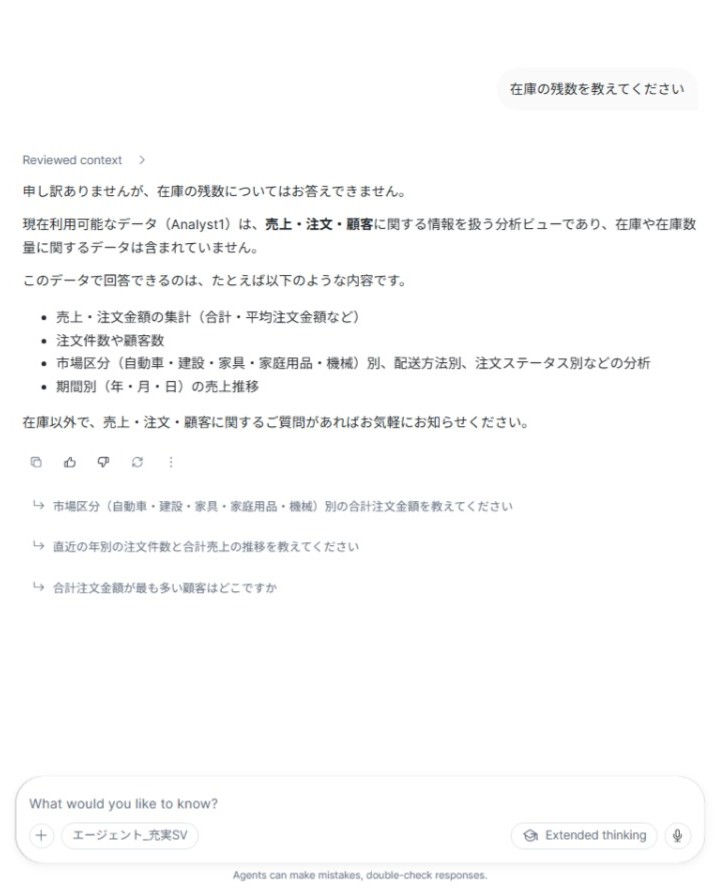
エージェントBの回答
ステップ5:結果の比較観点
各質問について、以下の観点で両エージェントの回答を比較しました。
【観点1:質問の解釈精度】(質問1・2・4で確認)
- エージェントA:SYNONYMSに「マーケットセグメント」などの日本語が登録されており、正しくマッピングされました
- エージェントB:SYNONYMSがないにもかかわらず、「マーケットセグメント」→
c_mktsegmentを正しく推測できました - → 結果:差異なし
TPC-Hは広く知られたベンチマークであり、LLM(大規模言語モデル)の学習データにテーブル構造やカラムの意味が含まれている可能性が高いと考えられます
【観点2:計算指標の算出可否】(質問3で確認)
- エージェントA:7つの配送方法の割引後売上合計を算出しました。AIRが約312.2億で最大、最小のTRUCKとの差は約0.4%です
- エージェントB:「このデータモデルでは算出できません」と回答しました。理由は、明細テーブルに金額・割引率の項目が定義されておらず、金額の指標が注文単位の合計金額しかないためです。誤った数値は出さず、代替案(件数ベースの集計、参考値としての注文合計金額、項目追加の依頼)を提示しました
- → 結果:差異あり
COMMENTなどの説明ではなく、割引後金額のFACT/METRICを定義したかどうかが、回答の可否に直接影響しました
【観点3:フィルタ値の精度】(質問4で確認)
- エージェントA:COMMENTに「F=完了」が定義されており、回答でも「完了(F)」と対応を明記して正しく絞り込みました
- エージェントB:SAMPLE_VALUESがないにもかかわらず、「完了」→
o_orderstatus = 'F'を正しくマッピングできました - → 結果:差異なし
TPC-Hのステータスコードの意味もLLMが把握していると考えられます
【観点4:回答の補足情報】(質問1・2で確認)
- エージェントA:セグメント名を「BUILDING(建設)」と日本語訳で併記し、注文ステータスの意味(F=完了、O=未処理、P=一部完了)を、COMMENTに定義された内容のまま説明しました
- エージェントB:COMMENTがないため、「F (Fulfilled/完了)」のように英語を補ったり、金額に「$」を付けたりするなど、LLMが自身の知識で補足しました。内容はおおむね妥当でしたが、定義に基づく説明ではありません
- → 結果:微差あり【推測】
COMMENTが定義されているかどうかが、回答の根拠の違い(セマンティックビューの定義を引用したか、LLM自身の知識で補ったか)に影響した可能性があります。ただし、この因果関係は回答文からの推測であり、定量的な指標で検証したものではありません
【観点5:対象外質問への対応】(質問5で確認)
- エージェントA:「在庫に関するデータは含まれていない」ため回答できないと述べたうえで、利用できるデータを「売上・注文・顧客に関する分析ビュー」と業務の言葉で説明し、回答できる分析例(売上・注文金額の集計、市場区分別・配送方法別の分析、期間別の推移など)を提示しました
- エージェントB:同じく「在庫に関するデータが含まれていない」ため回答できないと述べたうえで、利用できるデータをテーブル名(customers・orders・line_items)と項目名の一覧で説明し、「在庫データが別のデータソースにあれば、そのソースを選択してほしい」と案内しました
- → 結果:どちらも在庫の残数には回答しておらず、回答の可否に差異はありません。説明の仕方に微差あり【推測】(Aは業務視点、Bはデータ構造視点)
AI_QUESTION_CATEGORIZATIONの有無が影響した可能性はありますが、COMMENTなど他のメタデータとは切り分けておらず、推測です
【観点6:SQL生成ルールの反映】(質問2・4で確認)
- エージェントA:AI_SQL_GENERATIONの「日付でグルーピングする場合は新しい順に並べる」指示に沿って、注文年が新しい順(質問2では1998→1992、質問4では1995→1992)で表示されました
- エージェントB:指示がないため、古い順(質問2では1992→1998、質問4では1992→1995)で表示されました
- → 結果:微差あり【推測】
1回ずつの実行結果であり、LLMの出力のばらつきの可能性も否定できません
比較2のまとめ
| 観点 | エージェントA(充実したSV) | エージェントB(最小限のSV) | 差異 |
|---|---|---|---|
| 質問の解釈精度 | SYNONYMSで正確にマッピング | LLMの推測で正しくマッピング | なし |
| 計算指標の算出可否 | METRICSで定義済み → 正確 | 未定義のため算出できず | 差異あり |
| フィルタ値の精度 | COMMENTに値の意味を定義 → 正しく絞り込み | LLMの推測で正しくマッピング | なし |
| 回答の補足情報 | COMMENTを引用した説明 | LLMの知識に基づく推測的な説明 | 微差あり【推測】 |
| 対象外質問への対応 | 業務の言葉で説明し、答えられる分析例を提示 | テーブル・項目を列挙し、別のデータソースを案内 | 回答の可否は同じ。説明に微差あり【推測】 |
| SQL生成ルールの反映 | 年が新しい順で表示 | 年が古い順で表示 | 微差あり【推測】 |
※「微差あり【推測】」は、定量的な指標による判定ではなく、回答内容の質的な違いに基づく執筆者の主観的な解釈です。
今回の検証で明確な差が出たのは観点2(計算指標の算出可否)だけでした。
観点1・3では差が見られず、観点4〜6は微差【推測】にとどまりました。
観点1・3で差が小さかったのは、TPC-Hが広く知られたベンチマークデータで、テーブル構造や値の意味をLLMが学習データから補えたためと考えられます(推測)。
一方、観点2のように、セマンティックビューに定義のない計算式(割引後金額)は、エージェントが算出できませんでした。
3-3. 第3章のまとめ
本章の比較から、以下のことがわかりました。
- SEMANTIC_VIEW句を使うと、JOINや計算式を毎回書く必要がなくなり、特に複数テーブルにまたがる分析で記述量を減らせます。分析者は、メトリクス名とディメンション名を指定するだけで集計できます
- Cortex Agentsが構造化データをCortex Analystツールで分析するには、セマンティックビュー(または旧形式のセマンティックモデル)が必要です。セマンティックビューは、エージェントにデータの構造と意味を伝えるための中心的な仕組みです
- 今回の検証では、質問・値の解釈(観点1・3)では差が小さかった一方、計算ロジックの定義の有無(観点2)では回答の可否が分かれました。前者は、TPC-Hという広く知られたベンチマークデータを使用したため、LLMがカラムの意味や値の種類を学習データから推測できたことが主な原因と考えられます(推測)。後者は、割引後金額の計算式がセマンティックビューに定義されていなかったため、エージェントが算出できなかったものです
- ただし、業務固有のデータベース(独自のコード値・社内用語・非公開のテーブル設計・複雑な計算ロジック)では、LLMが事前知識を持たないため、メタデータの充実度がCortex Agentsの回答精度に大きく影響すると想定されます。COMMENT・SYNONYMS・SAMPLE_VALUES・AI_SQL_GENERATIONなどのメタデータ整備は、実務でのセマンティックビュー活用において重要な取り組みとなります
セマンティックビューは、SQLを書ける技術者にとっては記述量の削減と指標の一貫性を、ビジネスユーザーにとってはCortex Agentsを通じた自然言語分析を可能にしてくれます。
今回の検証では、TPC-Hが広く知られたデータであるためか(推測)、説明用メタデータの効果は限定的でしたが、計算ロジックの定義の有無は回答の可否を分けました。実務のデータでは、メタデータの充実がAIの回答品質を大きく左右すると想定されます。
まとめ
本記事では、Snowflakeのセマンティックビューについて、基本概念から作成手順、そして通常のSQLとの違いまでを実際に検証しながらご紹介しました。ポイントをまとめると、以下のとおりです。
- セマンティックビューは、物理テーブルにビジネス上の意味を与え、Fact・Dimension・Metricという3つの要素で構成されます
- SQL DDL・YAML・Snowsight UIの3つの方法で作成でき、DDLとYAMLは一部機能を除いて相互に変換できます
- SEMANTIC_VIEW句を使うと、JOINや計算式の記述が不要になり、特に複数テーブルの分析で記述量を減らせます
- Cortex AgentsがCortex Analystツールで構造化データを分析するには、セマンティックビュー(または旧形式のセマンティックモデル)が必要です。また、業務固有のデータでは、COMMENTやSYNONYMSなどのメタデータ整備が回答精度を大きく左右すると想定されます
セマンティックビューを整備しておけば、SQLに詳しい方は記述量の削減と指標の一貫性を、ビジネス部門の方はCortex Agentsを通じた自然言語でのデータ分析を、どちらも実現しやすくなります。
ぜひ皆さんの環境でも、お手持ちのテーブルにセマンティックビューを定義してみて、Cortex AgentsやSEMANTIC_VIEW句での分析を試してみてください。
参考


コメント